1. De la prédiction au langage utile
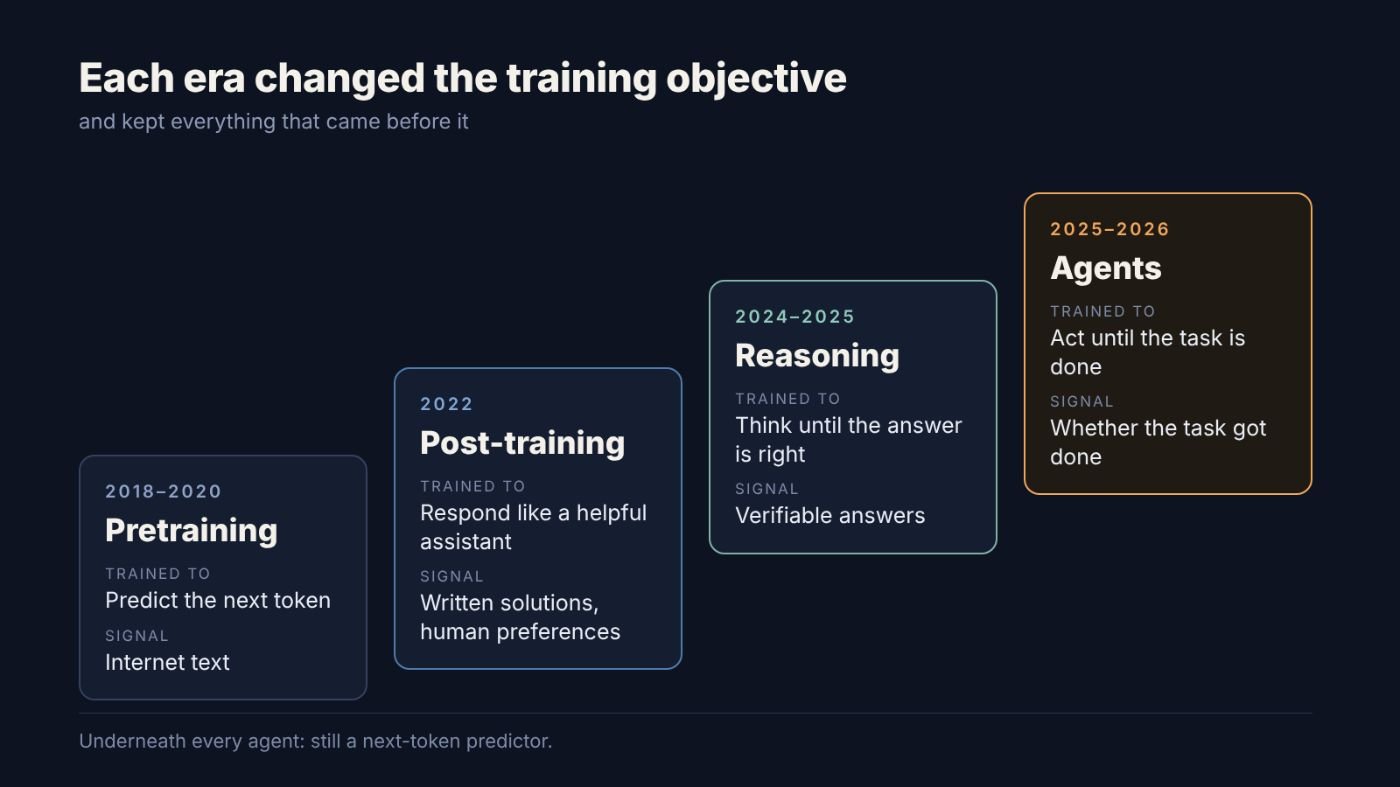
L’histoire des grands modèles de langage peut se lire comme une succession de changements d’objectif d’entraînement. Au départ, GPT-1 apprenait simplement à prédire le prochain token à partir d’un vaste corpus de textes. Ce choix a suffi à faire émerger des compétences inattendues : grammaire, syntaxe, faits généraux et début de compréhension sémantique. En 2019, GPT-2 a montré qu’en augmentant la taille du modèle et la quantité de données, il devenait possible de générer des textes plus cohérents, mais aussi de réaliser, sans adaptation spécifique, des tâches comme la synthèse, la traduction ou la réponse à des questions.
- GPT-1 a prouvé qu’un objectif simple pouvait faire apprendre le langage.
- GPT-2 a révélé les effets de l’échelle sur les capacités émergentes.
- Le modèle reste alors un générateur de texte, pas encore un assistant orienté vers l’utilité.
2. Le passage décisif vers l’assistant
Avec GPT-3, la logique a franchi un cap : le modèle pouvait suivre une consigne et apprendre une tâche à partir de quelques exemples intégrés dans le prompt, sans réentraînement. Mais un problème persistait : un modèle entraîné uniquement à continuer du texte ne sait pas quand répondre, quand s’arrêter, ni comment refuser une demande risquée. La solution est venue avec le post-entraînement, en particulier l’approche InstructGPT, qui combine exemples rédigés par des humains, classement des réponses par préférence, puis optimisation par apprentissage par renforcement à partir du feedback humain (RLHF).
- Les humains fournissent des réponses de référence de meilleure qualité.
- Les réponses du modèle sont évaluées et classées.
- Le modèle apprend à privilégier les sorties jugées les plus utiles, sûres et claires.
Ce tournant a été spectaculaire : un modèle bien aligné sur l’objectif a pu surpasser un système bien plus vaste mais moins bien orienté. Avec ChatGPT, l’IA conversationnelle est sortie du laboratoire pour devenir un produit de masse, capable de répondre, reformuler, expliquer et refuser certaines requêtes problématiques.
3. Quand le modèle apprend à raisonner
La phase suivante ne consistait plus seulement à répondre correctement, mais à raisonner avant de répondre. Les travaux sur le code et les mathématiques ont joué un rôle central, car ces domaines offrent un avantage rare : la réponse peut être vérifiée automatiquement. Un programme fonctionne ou échoue ; une démonstration mathématique est correcte ou non. Cela a permis de développer des méthodes de reinforcement learning with verifiable rewards (RLVR), où la récompense ne dépend pas d’un jugement humain constant, mais d’une vérification objective.
Des modèles récents comme o1 ont été entraînés à produire des chaînes de réflexion longues, à tester des pistes, à corriger leurs erreurs et à revenir en arrière. Une partie du raisonnement reste cachée à l’utilisateur, tandis que la réponse finale reste concise et lisible. Cette évolution a montré que la puissance ne vient pas seulement de la taille du modèle, mais aussi du fait de lui apprendre comment penser avant de répondre.
- Mathématiques et programmation sont devenues des terrains idéaux pour entraîner le raisonnement.
- La vérification automatique réduit le coût d’apprentissage.
- Le raisonnement devient une compétence entraînable, pas seulement une illusion de cohérence textuelle.
4. De la réflexion à l’action
Une fois le raisonnement maîtrisé, une autre limite est apparue : un modèle qui réfléchit ne peut pas, à lui seul, agir sur le monde. Il lui faut chercher une information, ouvrir un fichier, exécuter un test, consulter une base de données ou lancer une commande. C’est ainsi qu’est née la logique des agents : penser, agir, observer le résultat, puis recommencer jusqu’à atteindre un but précis. Cette idée a été rendue plus pratique par la généralisation de la function calling et par des standards d’intégration avec les outils et les données.
Les usages les plus visibles ont d’abord concerné la recherche documentaire, puis le développement logiciel. Dans la recherche, un agent peut interroger plusieurs sources, comparer les résultats et produire un rapport cité. Dans le code, il peut lire une base complète, modifier plusieurs fichiers, lancer des tests et corriger lui-même les erreurs détectées. Le résultat attendu n’est plus une simple réponse, mais un travail terminé.
- Recherche : collecte d’informations et synthèse argumentée.
- Codage : lecture, modification et validation de projets entiers.
- Gestion de tâches : fichiers, tableaux, rapports et actions répétées jusqu’au résultat.
5. Pourquoi cette progression a été si rapide
Si cette évolution s’est produite en moins d’une décennie, c’est parce que trois leviers se sont renforcés ensemble. D’abord, les modèles ont atteint une taille suffisante pour stocker des régularités complexes. Ensuite, les jeux de données ont été conçus pour enseigner de nouveaux comportements, et non plus seulement du texte brut. Enfin, les objectifs d’entraînement ont été ajustés pour enseigner ce qu’il fallait réellement obtenir : une bonne réponse, une solution vérifiable, une action utile ou un enchaînement de décisions cohérent.
Les avancées en architecture ont aussi compté : les connexions résiduelles, l’attention, les couches de normalisation et de meilleurs optimiseurs ont permis d’entraîner des réseaux profonds sans effondrement. Mais le point central reste le même : la qualité des données et l’objectif associé déterminent ce que le modèle apprend. Dans bien des cas, ce ne sont pas seulement des corpus plus larges, mais des corpus mieux pensés qui ont débloqué les progrès.
- Capacité : assez de paramètres pour représenter des motifs complexes.
- Données : des exemples adaptés à la compétence visée.
- Objectif : une manière claire de dire au modèle ce qui compte vraiment.
6. Ce que l’avenir laisse entrevoir
Les agents sont déjà capables de résoudre des tâches complexes, mais leur fiabilité reste inégale. Sur des travaux longs, une réussite à 50 % peut impressionner en démonstration, mais elle ne suffit pas pour un usage professionnel quotidien. Les progrès à venir dépendront donc moins d’une simple hausse de taille que de la création de meilleurs objectifs, de meilleurs tests et de meilleurs signaux d’apprentissage. Les domaines ouverts sont nombreux : mémoire persistante, apprentissage en cours de route, meilleure robustesse sur les tâches floues et amélioration continue de la vérification.
La trajectoire observée depuis GPT-1 montre une logique forte : chaque génération n’a pas remplacé la précédente, elle l’a complétée. Le modèle actuel reste, au fond, un prédicteur de tokens, mais il est désormais entraîné à être utile, à raisonner, puis à agir. La prochaine étape dépendra de la manière dont les chercheurs et les entreprises sauront définir ce qu’un agent doit considérer comme un travail bien fait, et comment mesurer ce résultat avec précision.
- Fiabilité : réduire les erreurs sur les tâches longues.
- Mémoire : permettre aux modèles de retenir le contexte et d’apprendre en continu.
- Évaluation : mieux définir ce qu’est une tâche réussie.
En savoir plus sur L'ABESTIT
Subscribe to get the latest posts sent to your email.