
Du prompt à l’architecture: le vrai tournant de l’IA
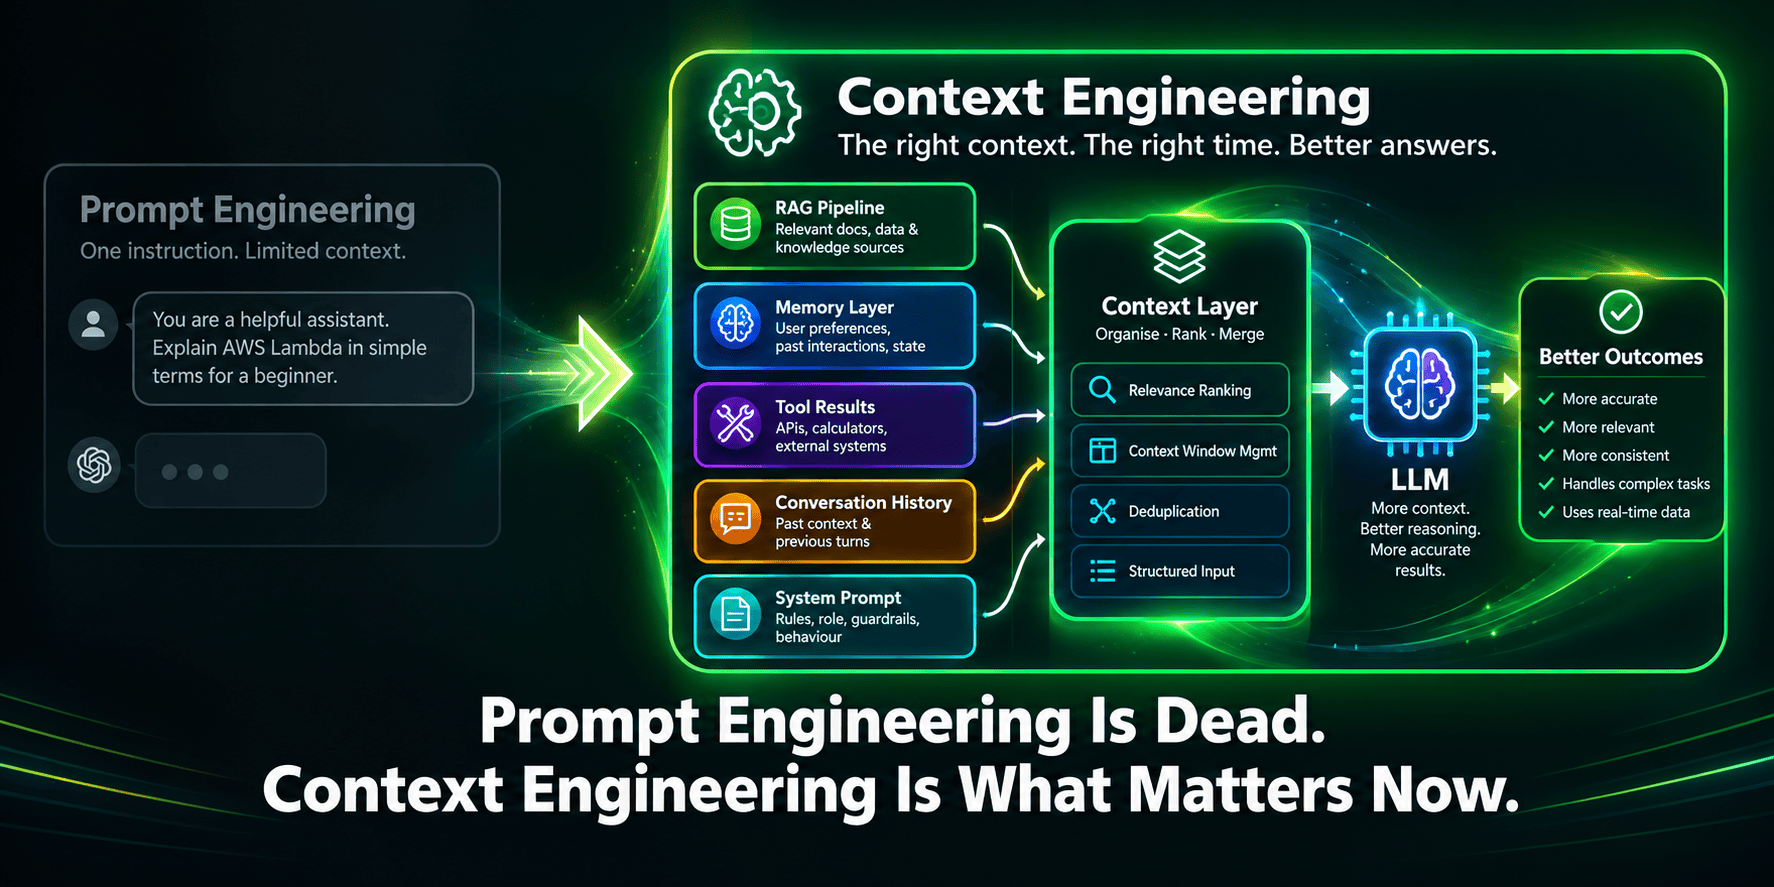
En 2026, le débat ne porte plus seulement sur la manière de formuler une demande à une IA, mais sur l’ensemble des informations qu’elle reçoit au moment de répondre. C’est précisément le cœur du context engineering, une approche qui consiste à organiser, filtrer et enrichir tout ce que le modèle voit: instructions, historique, documents récupérés, résultats d’outils et mémoire persistante. Là où le prompt engineering cherchait à améliorer la formulation, le context engineering cherche à améliorer la qualité du contexte. Cette évolution devient décisive à mesure que les modèles savent mieux suivre les instructions, rendant les limites d’information plus visibles que les limites de style.
Pourquoi les prompts ne suffisent plus
Le prompt engineering a dominé les débuts de l’IA générative, notamment en 2022 et 2023, quand quelques ajustements de ton, de format ou d’exemples pouvaient transformer une réponse médiocre en réponse utile. Cette logique reste valable, mais elle atteint vite ses limites lorsque le modèle manque d’éléments concrets pour raisonner. Un assistant client peut être impeccablement briefé, il n’empêchera pas une erreur si la politique de remboursement n’est pas accessible, si l’historique du compte est absent ou si la documentation est obsolète. Autrement dit, une instruction claire ne crée pas une information manquante. C’est dans cet écart entre l’ordre donné et la donnée disponible que le contexte devient déterminant.
- Le prompt règle la manière de demander.
- Le contexte règle ce que le modèle sait au moment de répondre.
- La précision dépend autant des données fournies que des consignes.
Ce que recouvre vraiment le context engineering
Le context engineering ne se limite pas au message système: il englobe tout ce que le modèle reçoit dans sa fenêtre de contexte. Cela inclut le texte de l’utilisateur, l’historique de la conversation, les documents récupérés via une base de connaissances, les réponses d’API, les résultats d’une recherche web, ainsi que la mémoire enregistrée d’une session à l’autre. Dans un système bien conçu, chaque couche a un rôle distinct. Le prompt fixe les règles, la récupération documentaire apporte les faits, les outils fournissent des données à jour, et la mémoire personnalise l’échange. Cette organisation évite un piège fréquent: mélanger des consignes, des connaissances et des exemples dans un seul bloc confus, ce qui dilue l’attention du modèle.
- Instructions système: cadrer le comportement.
- Historique: conserver la cohérence d’un échange long.
- Récupération documentaire: injecter des faits pertinents.
- Résultats d’outils: fournir des informations calculées ou interrogées en direct.
- Mémoire: retenir les préférences et le profil utilisateur.
Les cinq couches qui façonnent une réponse fiable
Dans la pratique, la robustesse d’un agent IA dépend de cinq couches. La première est le system prompt, qui doit rester court, net et centré sur le comportement attendu. La deuxième est le contexte récupéré, souvent issu d’un système RAG, où la qualité du découpage des documents, du filtrage et du classement des passages influe directement sur la réponse. La troisième couche est l’historique de conversation, qu’il faut compresser intelligemment pour éviter qu’il n’étouffe les informations récentes. La quatrième concerne les outils, dont les sorties doivent être nettoyées et reformattées avant d’entrer dans la fenêtre de contexte. La cinquième est la mémoire persistante, utile pour rappeler au modèle des éléments stables comme une préférence de format ou un projet en cours.
- Un bon système prompt donne des règles simples et non redondantes.
- Une bonne récupération renvoie peu de passages, mais les bons.
- Une bonne mémoire sélectionne ce qui mérite vraiment d’être conservé.
- Un bon formatage réduit le bruit et augmente la lisibilité.
Diagnostiquer un problème d’IA comme un problème de contexte
De nombreux défauts attribués à tort au modèle relèvent en réalité d’un défaut de contexte. Si une IA donne des informations périmées, le problème vient souvent d’une base documentaire non mise à jour ou d’un système de récupération qui favorise d’anciens passages. Si elle se contredit après plusieurs échanges, c’est généralement un souci de gestion de l’historique ou de compression trop agressive. Si elle invente des faits avec assurance, c’est souvent qu’aucune source fiable ne lui a été fournie au moment de répondre. Si elle ignore des documents pourtant présents, c’est peut-être que ceux-ci sont mal positionnés, mal étiquetés ou noyés dans trop de contenu. La bonne question n’est donc pas seulement « Comment mieux formuler ? », mais « Quelles informations manquent, lesquelles sont inutiles, et où se trouvent-elles ? ».
- Réponse obsolète : problème de récupération ou de fraîcheur des sources.
- Contradiction : problème d’historique ou de mémoire.
- Hallucination : absence de preuve dans le contexte.
- Ignorance d’un document : structure ou hiérarchie du contexte à revoir.
La méthode la plus efficace pour construire de meilleurs agents
La démarche la plus utile consiste à auditer le contexte réel, ligne par ligne, pour voir ce que le modèle reçoit effectivement. Il faut identifier les informations manquantes, retirer les éléments superflus et repositionner ce qui est essentiel près des zones auxquelles le modèle accorde le plus d’attention. Dans un système de support, par exemple, un bon design ne met pas la politique de remboursement dans un long paragraphe au milieu d’un bloc de texte: il l’extrait, l’étiquette clairement et la relie à la demande en cours. Pour les conversations longues, les échanges anciens doivent être résumés sans perdre les décisions importantes, tandis que les derniers tours restent visibles. Pour la mémoire, il faut sélectionner uniquement les éléments stables et vraiment utiles, au lieu de tout conserver indistinctement. Le résultat est un agent plus fiable, plus cohérent et plus sobre en tokens.
- Cartographier le contexte complet transmis au modèle.
- Supprimer les doublons et les informations non utiles.
- Résumer l’historique ancien sans effacer les décisions clés.
- Hiérarchiser les passages importants dans la fenêtre de contexte.
- Tester l’impact des données ajoutées, pas seulement des mots changés.
Une compétence d’ingénierie pour l’IA de demain
Le context engineering s’impose comme une compétence de systèmes, pas seulement de langage. Il mobilise des savoir-faire proches de l’architecture logicielle: gestion des flux de données, recherche d’information, orchestration d’outils, budgétisation des tokens, traçabilité des sources et personnalisation contrôlée. Dans les applications les plus fiables, le travail ne consiste plus à écrire des prompts toujours plus longs, mais à concevoir un environnement informationnel intelligent autour du modèle. C’est cette discipline qui permet d’obtenir des réponses précises, cohérentes et adaptées au besoin réel. En pratique, le vrai levier n’est plus seulement ce que l’on dit à l’IA, mais ce qu’on lui permet de savoir au moment exact où elle répond.


Ne nourrissez pas les trolls, pixies, gobelins et imps politiques
Quand les trolls cherchent à détourner l’attention
Dans l’univers numérique, l’expression “Don’t feed the trolls” invite à ne pas offrir de réponse à ceux qui provoquent volontairement des réactions. Un troll est généralement un internaute qui publie des messages destinés à agacer, déstabiliser ou faire dérailler une discussion. L’idée centrale est simple : plus on réagit, plus on renforce leur objectif. Dans un forum, sous une publication ou dans un fil de commentaires, l’absence de réponse peut souvent réduire l’impact de ces interventions nuisibles.
Comprendre le mécanisme derrière la provocation
Les trolls s’appuient souvent sur la réaction émotionnelle des autres. Ils peuvent utiliser l’ironie, la mauvaise foi, les attaques personnelles ou des propos volontairement absurdes pour capter l’attention. Par exemple, dans un groupe de discussion sur le sport, un troll peut lancer une remarque provocatrice sur une équipe populaire uniquement pour déclencher une dispute. Leur force ne vient pas de leurs arguments, mais de l’engagement qu’ils suscitent.
Pourquoi répondre peut aggraver la situation
Répondre à un troll peut sembler naturel, surtout lorsqu’un message paraît injuste ou insultant. Pourtant, cela peut parfois amplifier le problème. Une réponse, même mesurée, signale que le message a atteint son objectif. Sur les réseaux sociaux, une polémique peut rapidement prendre de l’ampleur lorsqu’elle est relayée par des réponses indignées. Les trolls profitent alors de la visibilité, du désordre et de la confusion qu’ils provoquent.
Les bonnes pratiques pour limiter leur influence
Face à une tentative de provocation, plusieurs réflexes sont recommandés pour préserver des échanges sains :
Quand le silence est utile, mais pas toujours suffisant
Ne pas nourrir le troll est souvent une stratégie efficace, mais elle ne remplace pas une vraie gestion des abus. Dans certains cas, notamment en cas de harcèlement répété, de menaces ou de diffusion de fausses informations, il faut aller plus loin. Les outils de modération, les règles de communauté et la vigilance des utilisateurs jouent alors un rôle essentiel. Dans un espace public en ligne, protéger la qualité des échanges passe aussi par une action collective.
Préserver des échanges constructifs en ligne
Cette règle devenue célèbre rappelle une réalité importante : les espaces numériques reposent sur l’attention des utilisateurs. En refusant d’alimenter la provocation, on réduit la portée des comportements toxiques et on favorise des discussions plus utiles. Dans un débat sur l’actualité, une communauté de passionnés ou un espace d’entraide, la maîtrise de soi et la culture du dialogue restent les meilleurs moyens de garder un environnement sain et crédible.